Homelab
Nueve máquinas, cuatro VLAN segmentadas, copias diarias con restauración probada y todos los servicios por HTTPS válido sin abrir un solo puerto al exterior.
- Máquinas
- 9 (8 contenedores, 1 VM + OPNsense)
- VLAN
- 4
- Puertos abiertos al exterior
- 0
- Backup diario
- 02:30, 9 máquinas en 5 min 51 s
- Restauración probada
- Sí, de extremo a extremo
- Errores documentados
- 18
- Stack
- Proxmox VE, OPNsense, Tailscale, Proxmox Backup Server, Nginx Proxy Manager, Docker, Debian
Un servidor pequeño en casa que aloja lo que antes estaba repartido entre servicios de terceros: fotos, contraseñas, biblioteca multimedia, y un laboratorio aislado para practicar seguridad ofensiva. Desde septiembre, además, aloja el backend de NOVA.
La parte interesante no es la lista de servicios, que es la de siempre. Es la red (cuatro VLAN separadas, un cortafuegos propio entre ellas y acceso remoto por red privada sin exponer nada a internet), las copias de seguridad, y sobre todo la sección de errores, que tiene más entradas que la de aciertos y es la parte más útil de todo el documento.
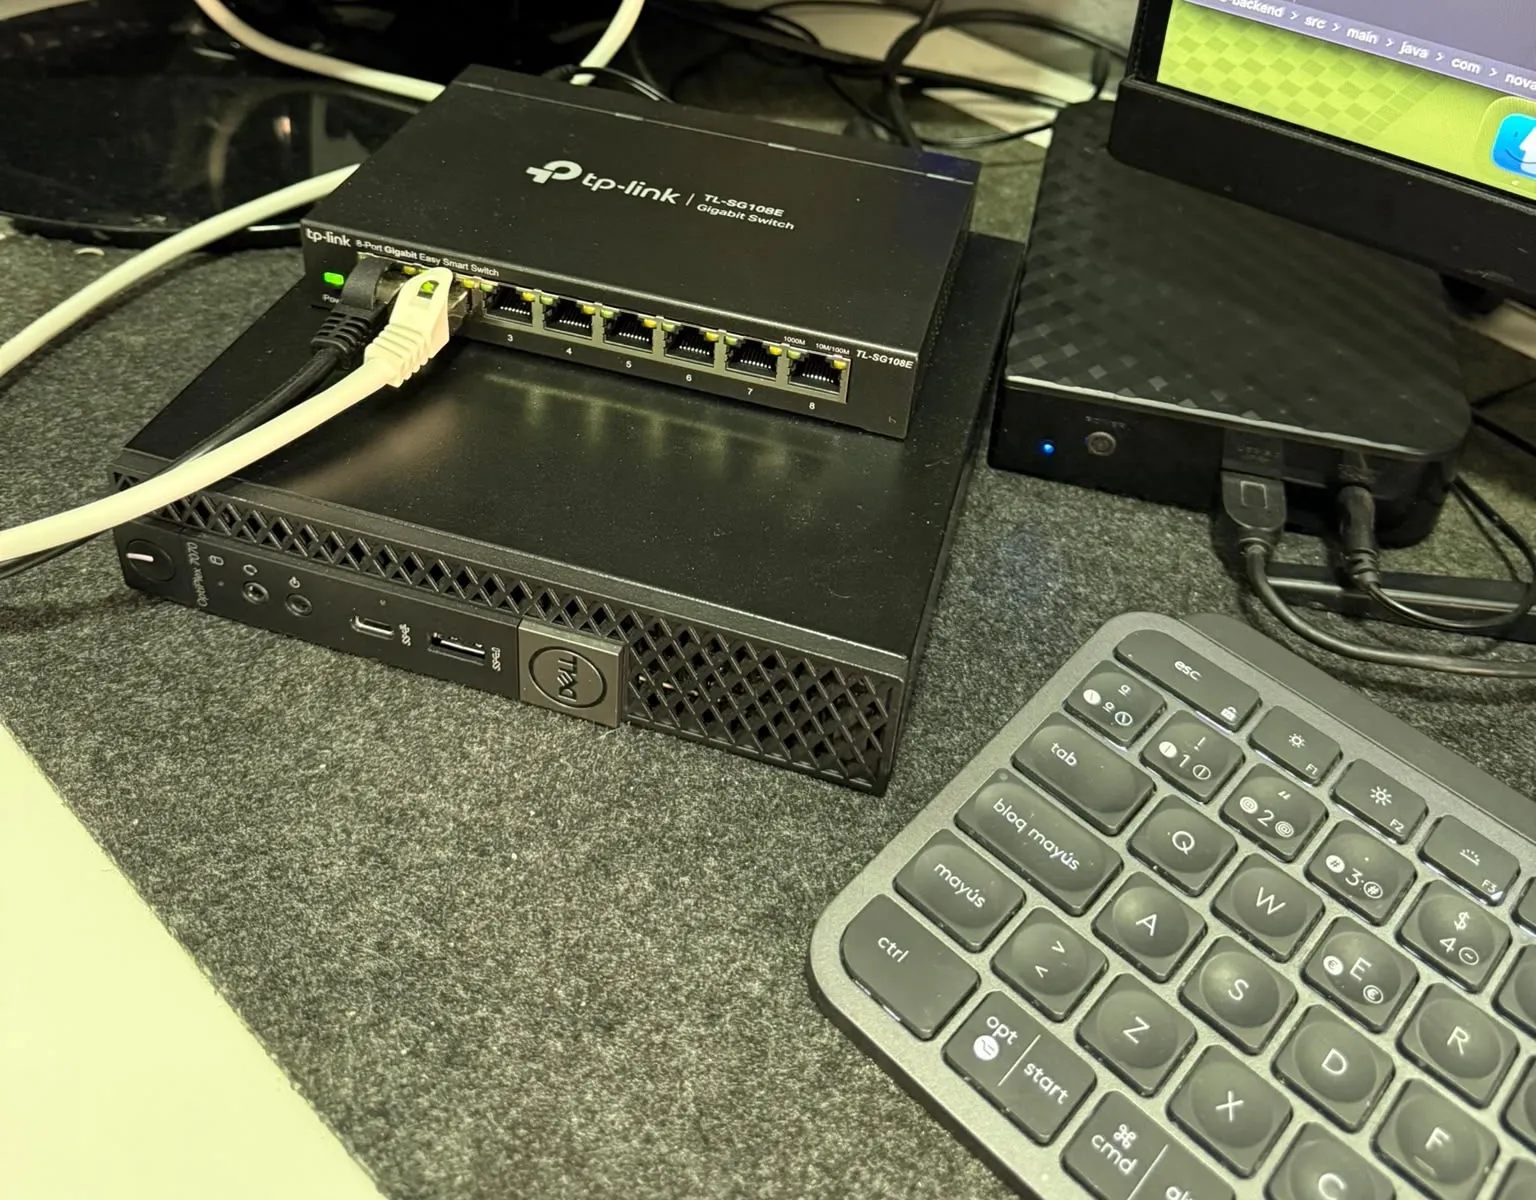
Hardware
| Equipo | Especificaciones | Rol |
|---|---|---|
| Dell OptiPlex 7070 Micro | i7-9700T (8 núcleos), 32 GB DDR4, NVMe de 256 GB | Servidor principal |
| Acer Aspire E15 | i7-4510U, 8 GB, HDD de 1 TB | Máquina de práctica |
| TP-Link TL-SG108E | 8 puertos gigabit, gestionable 802.1Q | Switch |
| Verbatim Store ‘n’ Save | 6 TB, USB 3.0, HDD de 5.400 rpm con alimentación externa | Almacenamiento principal: media, fotos y backups |
| Router del operador | Salida a internet |
El Dell se compró de segunda mano por 289 €, con 30.400 horas en el NVMe y un 95 % de salud. Dos detalles que cuestan una tarde si no se saben: el 7070 Micro no tiene HDMI (hace falta adaptador desde DisplayPort) y el USB-C frontal no da salida de vídeo.
Arquitectura de red
                    Internet
                        |
              Router del operador
                        |
                        | cable -> puerto 1
                        v
              Switch TP-Link TL-SG108E
                        |
                        | puerto 2 (trunk, VLAN 10/20/50 etiquetadas)
                        v
              +-----------------------------------+
              |   Dell - Proxmox VE 8.4           |
              |                                   |
              |   eno2 (NIC física)               |
              |    +-- vmbr0   (sin etiqueta)     |  red de casa
              |    +-- eno2.10 -> vmbr10          |  Management
              |    +-- eno2.20 -> vmbr20          |  Services
              |    +-- eno2.50 -> vmbr50          |  Lab
              |                                   |
              |   VM 100: OPNsense                |  una pata en cada bridge
              |   CT: Pi-hole, Jellyfin,          |
              |       qBittorrent, Vaultwarden,   |  -> vmbr20
              |       PBS, NPM, Immich            |
              |   VM: Kali Linux                  |  -> vmbr50
              |                                   |
              |   Verbatim 6 TB (USB 3.0)         |
              |    +-- library/  -> Immich        |
              |    +-- media/    -> Jellyfin, qBittorrent
              |    +-- backups/  -> datastore de PBS
+-----------------------------------+| VLAN | Nombre | Para qué | DHCP |
|---|---|---|---|
| — | Casa (sin etiqueta) | La red del operador, como estaba | Router |
| 10 | Management | Proxmox y la administración de OPNsense | Sí |
| 20 | Services | Todos los servicios de uso diario | Sí |
| 50 | Lab | Kali y máquinas vulnerables | No, a propósito |
La VLAN de laboratorio no tiene DHCP: las máquinas vulnerables llevan IP fija para saber exactamente a qué se está atacando. Y el laboratorio no está aislado de internet, que fue el diseño original: para conectarse a laboratorios externos por VPN necesita salir. Lo que hay que evitar es que contamine Management, Services o la red de casa, no que le falte salida.
La decisión clave: un bridge por VLAN
En Proxmox hay dos formas de hacer VLAN: un único bridge en modo vlan-aware con las VLAN 802.1Q definidas dentro de OPNsense, o un bridge por VLAN, cada uno con su propia subinterfaz física. Se eligió lo segundo.
Por qué: la primera opción es exactamente lo que rompió el montaje en el
primer intento, porque acabé con las dos capas de etiquetado superpuestas
(ver errores). Con un bridge por VLAN, Proxmox hace todo el etiquetado,
OPNsense ve cuatro interfaces normales sin saber nada de 802.1Q, y los
contenedores se enchufan a su bridge sin configurar etiquetas. Es más
verboso en /etc/network/interfaces, pero es imposible de confundir.
Por qué 10.10.x.x y no 192.168.x.x
Casi todos los routers domésticos usan 192.168.1.x. Al intentar acceder a
un servicio del homelab desde otra red que también usaba ese rango, el
portátil asumía que la IP era local y nunca enrutaba el tráfico por el
túnel. Con 10.10.x.x no hay colisión: el cliente sabe que esa IP no es de su
red y la manda por Tailscale.
Servicios
| Servicio | Forma | Para qué |
|---|---|---|
| OPNsense | VM | Cortafuegos entre VLAN y DHCP de cada una |
| Pi-hole | LXC | DNS de toda la infraestructura, con bloqueo de publicidad. OPNsense lo usa para sus propias consultas y lo reparte por DHCP |
| Jellyfin | LXC | Biblioteca multimedia, con transcodificación por hardware (QuickSync) |
| qBittorrent | LXC | Descargas, con las carpetas compartidas con Jellyfin por bind mount |
| Vaultwarden | LXC + Docker | Gestor de contraseñas; el vault se migró desde la nube |
| Proxmox Backup Server | LXC | Copias incrementales y deduplicadas de todo |
| Nginx Proxy Manager | LXC + Docker | Punto de entrada único con certificado wildcard |
| Immich | LXC + Docker Compose | Fotos y vídeos; el servicio de más impacto diario |
| Kali Linux | VM | Pentesting, en la VLAN de laboratorio |
Dos decisiones de forma que merecen explicación. Kali va como máquina virtual completa y no como contenedor porque un LXC comparte el kernel del host, y las herramientas de pentesting necesitan manipular la pila de red a bajo nivel (captura en modo promiscuo, inyección de tráfico). Y PBS va en LXC pese a que Proxmox recomienda VM o hardware dedicado: el argumento decisivo fue el disco, porque en LXC el almacén se conecta con un bind mount idéntico al de Jellyfin, mientras que en VM habría que hacer passthrough de un disco USB, bastante más frágil. El motivo de fondo de la recomendación oficial, que el backup no comparta destino con lo que respalda, tampoco se cumpliría con una VM: el disco está enchufado al mismo Dell.
Acceso remoto sin abrir puertos
Todo el acceso entra por Tailscale. El Dell anuncia las subredes de Services y Lab, así que desde el portátil o el móvil, en cualquier red, se llega a cualquier servicio como si estuviera en casa. El router no tiene ningún puerto abierto.
Hasta cierto punto eso se hacía por IP:puerto sin cifrar, con avisos de
«sitio no seguro» y apps nativas que rechazan certificados inválidos. La
solución fue un punto de entrada único con URL limpias y HTTPS real:
Navegador (en el tailnet)  ---  https://servicio.ayyoub.dev  --->
   1. DNS: Cloudflare responde con la IP privada del proxy
   2. El tráfico viaja por Tailscale hasta la VLAN Services
   3. Nginx Proxy Manager termina el TLS con el certificado *.ayyoub.dev,
      lee la cabecera Host y reenvía al servicio correcto
Tres piezas: Cloudflare como DNS autoritativo del dominio (y la API con la que se demuestra su propiedad), Let’s Encrypt emitiendo un certificado wildcard por validación DNS-01, y Nginx Proxy Manager enrutando por nombre de dominio. Un único servidor atiende así decenas de subdominios en el mismo puerto 443.
Dos detalles que conviene saber. Los registros DNS públicos resuelven a
direcciones privadas: cualquiera puede consultar el nombre, pero solo quien
esté dentro del tailnet llega a la IP. Y el dominio .dev está en la lista
de precarga HSTS de los navegadores, que fuerzan HTTPS en todo el dominio; no
hay atajo posible con HTTP plano, lo cual aquí era el objetivo.
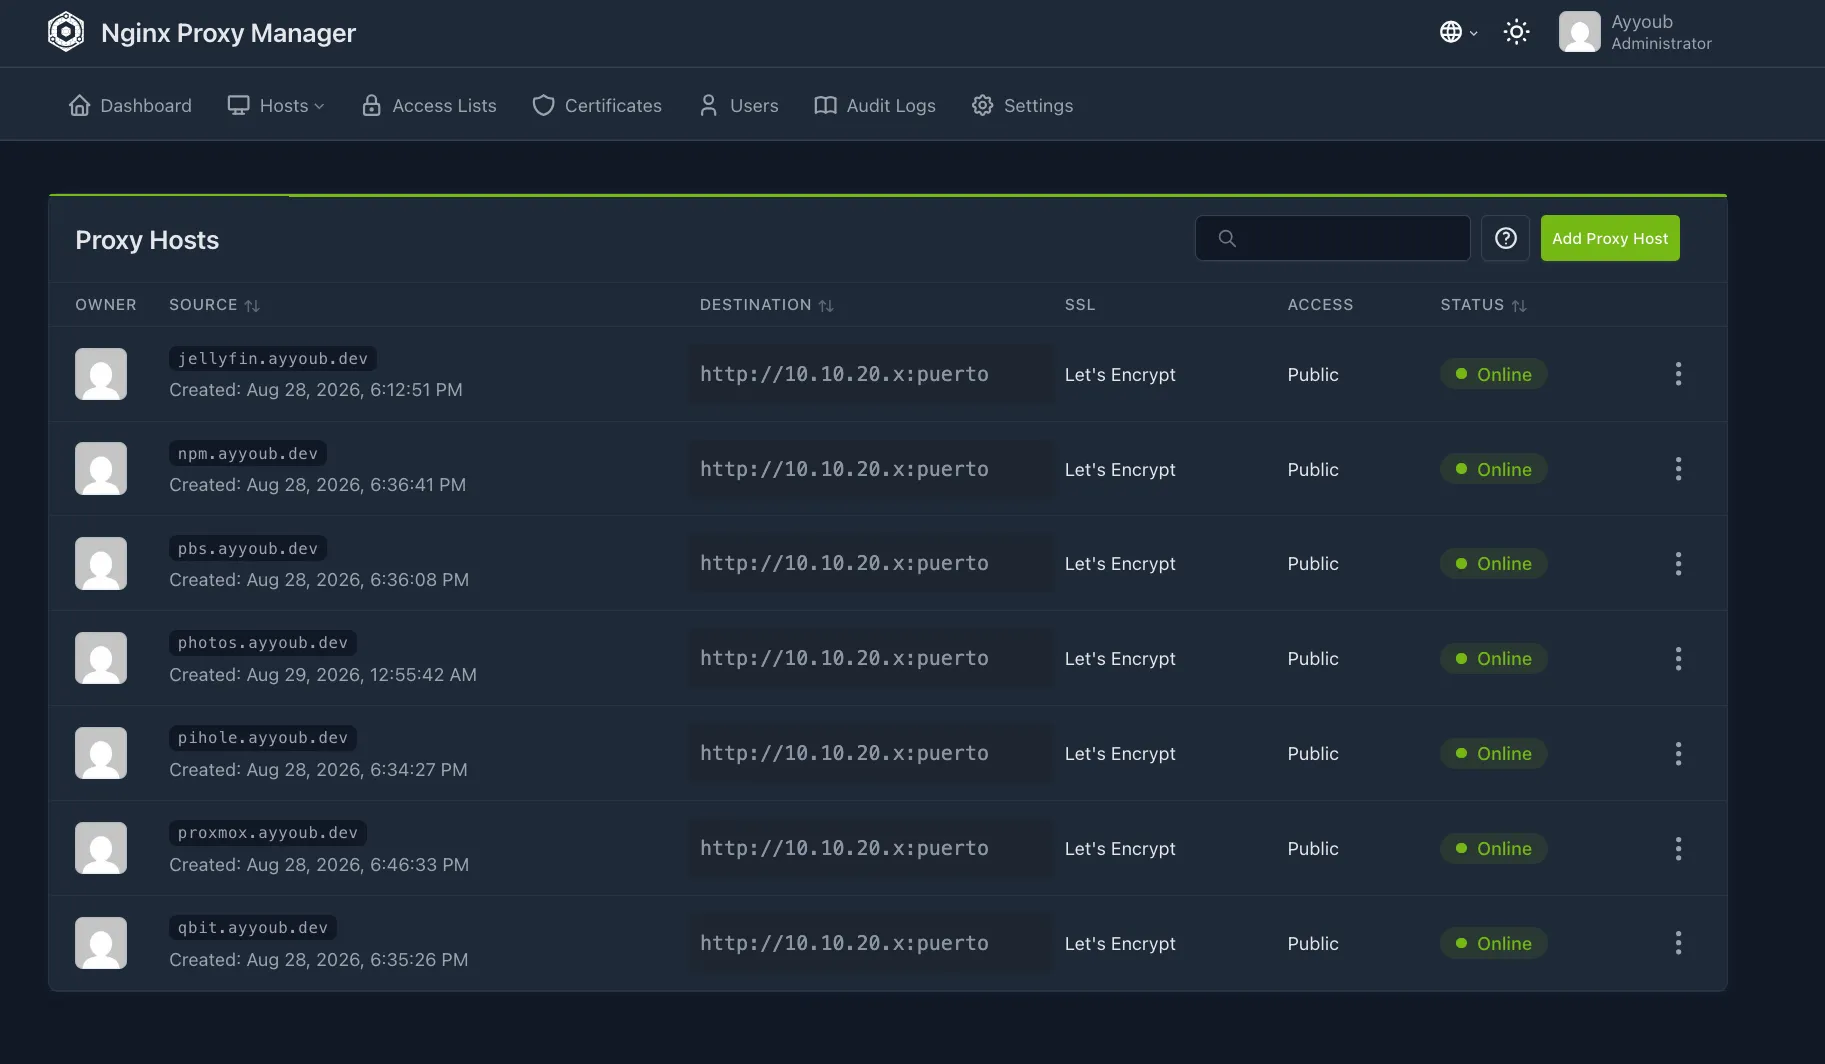
Lo que deliberadamente no se publica
OPNsense vive en Management, y las reglas del cortafuegos bloquean el tráfico de Services hacia Management. El proxy está en Services: no puede alcanzar OPNsense. Hacerlo funcionar exigiría abrir un agujero en esa regla, es decir, debilitar el aislamiento de Management para exponer justamente el cortafuegos que lo gobierna. Se descartó. OPNsense se sigue administrando por túnel SSH, y la fricción es proporcional a lo poco que se toca y lo mucho que importa.
Vaultwarden tampoco pasa por el proxy: ya tiene certificado válido por Tailscale Serve, que emite certificados reales para cualquier nodo de la red sin gestionar ninguna CA, y todas las apps cliente están configuradas con esa URL. Añadir el proxy encima sería duplicar caminos hacia un servicio que ya tiene HTTPS.
Y esta web
Se planteó alojar ayyoub.dev en el propio homelab. Hoy no hay ningún puerto
abierto y una web pública rompería esa propiedad, así que las opciones eran
un túnel saliente (Cloudflare Tunnel: el router sigue cerrado, la IP
residencial no se expone), alojarla fuera (Cloudflare Pages, GitHub Pages),
o abrir 80/443 en el router. La última es la única que expone la IP de casa
y sufre el escaneo constante de bots. Esta web está, de momento, fuera.
Almacenamiento
El disco de 6 TB venía de fábrica en NTFS con material antiguo. Antes de decidir nada se montó en solo lectura, que es el paso que hace imposible estropear algo mientras se piensa. Un detalle a recordar: la partición de datos era la segunda, no la primera; la primera, de 16 MB, es una partición reservada que Windows crea en discos GPT. Asumir que «la primera es la de datos» habría llevado a montar la equivocada.
Después: reparticionado a ext4, montaje permanente por UUID (verificado tras reinicio) y tres carpetas que no son la misma cosa:
library/: las fotos y vídeos de Immich. Datos originales.media/: películas y series. Consumible y reemplazable.backups/: el almacén de Proxmox Backup Server, sin acceso desde ningún otro contenedor.
Si se pierden las películas, se vuelven a descargar; si se pierden las fotos, no. Eso convierte la biblioteca en el segundo dato más crítico del homelab, después del vault de contraseñas, y es lo que ordena todo lo demás.
El disco que se dormía
Los HDD externos entran en reposo por dos vías distintas: la lógica interna
de la carcasa, que el sistema a menudo no puede tocar, y la gestión de
energía por comandos ATA. Este puente USB-SATA sí transmite comandos ATA,
así que hdparm -B 255 -S 0 desactiva el aparcado. Como se pierde al
reconectar, una regla de udev lo reaplica cada vez que el disco aparece.
La regla estuvo a punto de no funcionar nunca. El primer intento filtraba por
ID_SERIAL buscando «Verbatim», pero ese identificador reporta el disco
interno real (un Toshiba), no la carcasa; la cadena solo aparece en
ID_USB_SERIAL. La regla se habría quedado en el sistema aparentando estar
configurada. La verificación que lo convierte en «está configurado» es por
reversión: forzar a mano el estado contrario, disparar la regla y comprobar
que lo revierte. Devolvió el valor correcto, y eso demuestra que la regla se
ejecuta, no que el valor simplemente siguiera como estaba.
Copias de seguridad
Hasta finales de agosto el homelab no tenía backups de ningún tipo. Un fallo del NVMe se habría llevado la configuración de OPNsense (VLAN y reglas desde cero), el vault de contraseñas y la configuración de todos los contenedores.
PBS frente a los backups nativos
| Criterio | Proxmox Backup Server | Nativos de PVE |
|---|---|---|
| Incrementales | Sí, reales | No: volcado completo cada vez |
| Deduplicación | Sí | No |
| Restaurar un fichero suelto | Sí | No, solo el volcado entero |
| Complejidad | Media | Mínima |
Se eligió PBS por la restauración granular y por los incrementales, que convierten un backup diario en cuestión de segundos: el primero tardó 22 s, los siguientes menos. Trabajo diario a las 02:30 con retención de 7 diarios, 4 semanales y 6 mensuales. El primer trabajo automático se verificó al día siguiente: nueve máquinas en 5 min 51 s, incluido un contenedor creado esa misma noche.
La restauración, que es el paso que no se salta
Un backup que no se ha restaurado nunca es una suposición, no un backup. Se restauró el contenedor de Vaultwarden a un contenedor nuevo, sin tocar el de producción y sin arrancarlo automáticamente (heredaría la configuración de red del original y habría conflicto de IP). Luego, con el restaurado arrancado:
db.sqlite3          286720 bytes   <- el vault
db.sqlite3-wal           0 bytes   <- sin transacciones a medias en el snapshot
rsa_key.pem           1675 bytes   <- firma los tokens de sesión
Cada fichero confirma una cosa distinta. El WAL a cero bytes era precisamente la duda del modo snapshot: salió limpio. Sin la clave RSA, todos los dispositivos tendrían que volver a autenticarse.
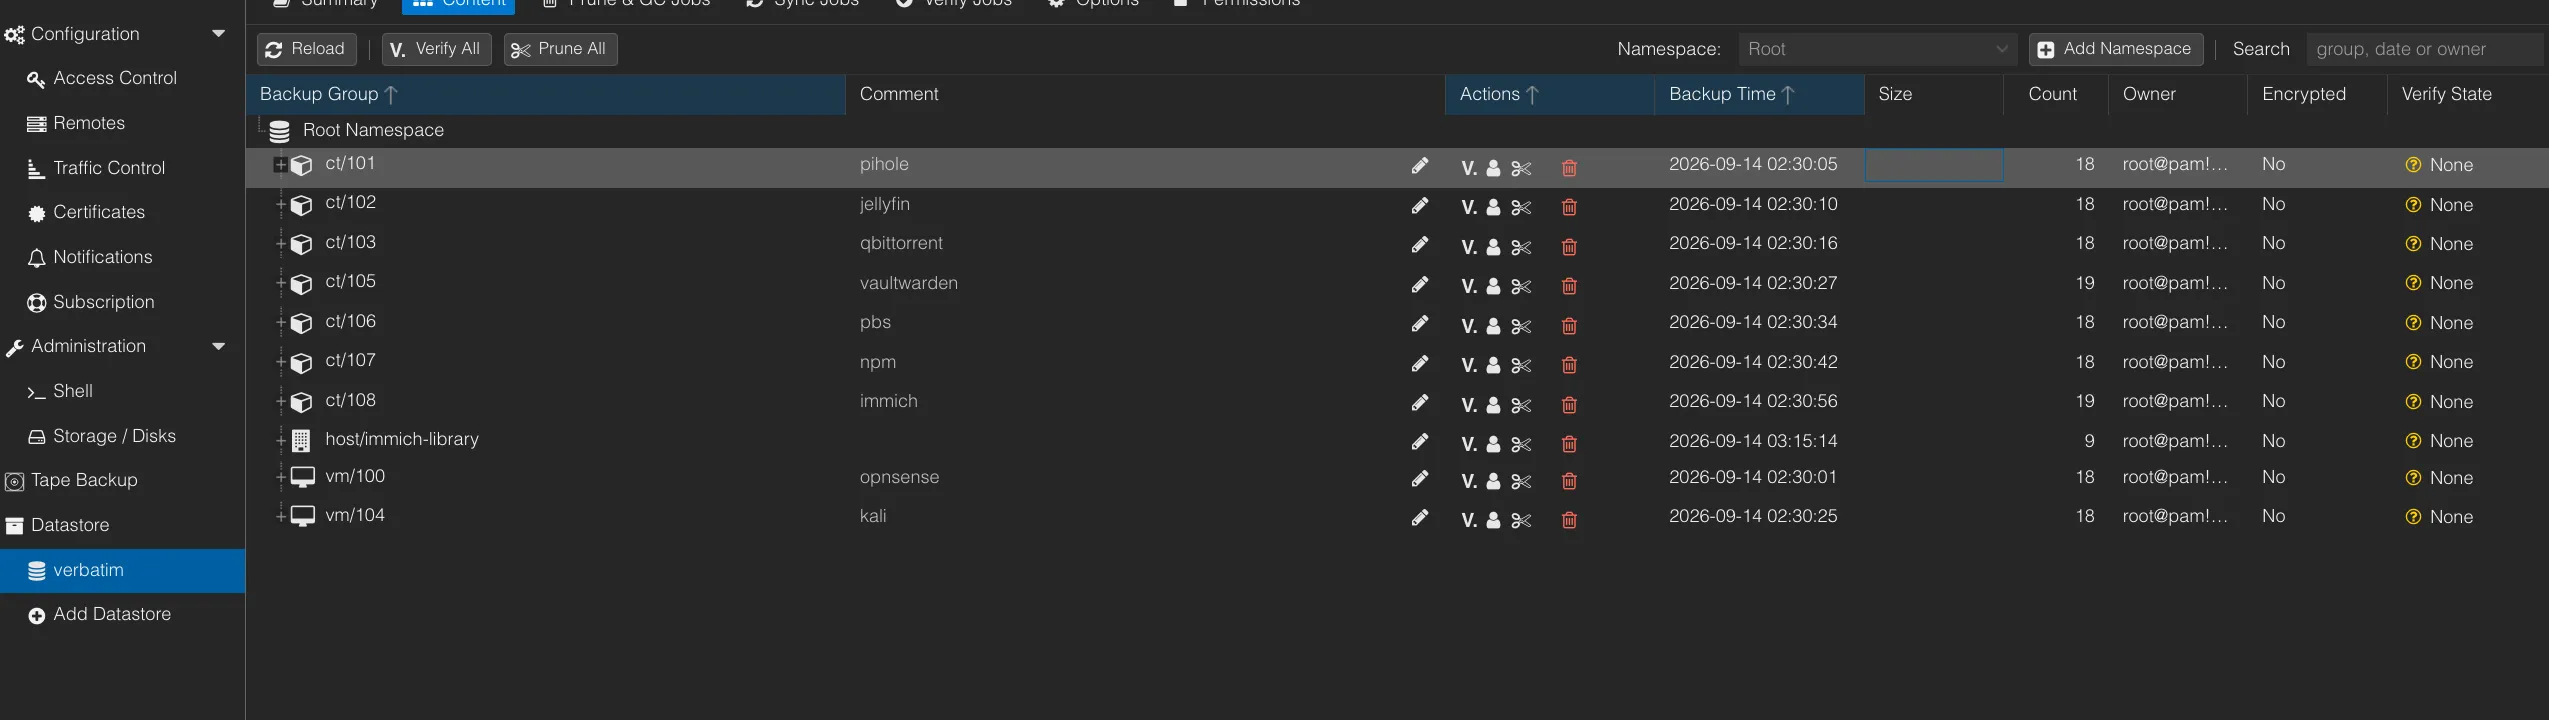
Lo que el backup no cubría
Al día siguiente de subir las primeras 4.133 fotos a Immich, y antes de borrarlas del iPhone, se comprobó que estuvieran respaldadas. No lo estaban.
La señal fue la duración: un backup manual del contenedor de Immich terminó
con TASK OK en tres minutos, imposible para 44 GB sobre un disco USB. El
datastore seguía ocupando lo mismo que antes de subir la biblioteca. Y el log
lo decía, en una línea fácil de pasar por alto:
INFO: excluding bind mount point mp0 ('/library') from backup (not a volume)vzdump no respalda bind mounts. Nunca. Solo respalda volúmenes gestionados
por Proxmox; un bind mount apunta a una carpeta arbitraria del host y lo
ignora por diseño. Añadir backup=1 al punto de montaje no sirve: esa opción
solo aplica a volúmenes. Y no era solo Immich: el mismo razonamiento aplica
a media/, solo que ahí es irrelevante.
De tres opciones (cliente de PBS desde el host, rsync a otro disco, o
convertir el bind mount en volumen), se eligió la primera:
proxmox-backup-client respaldando el directorio directamente al datastore
existente, programado con un timer de systemd a las 03:15. Reutiliza la
infraestructura que ya había.
Estado de la protección
| Dato | Respaldado por | Copia |
|---|---|---|
| Contenedores y VM | vzdump a PBS, diario a las 02:30 | Verbatim |
| Base de datos de Immich | Dentro del contenedor | Verbatim |
| Biblioteca de fotos (44 GB) | proxmox-backup-client, diario a las 03:15 | Verbatim |
| Vault de contraseñas | Dentro del contenedor | Verbatim |
| Media | Sin respaldar, a propósito: es reemplazable | — |
Todo está en el mismo disco físico. La protección cubre errores propios, corrupción lógica y el fallo del NVMe. No cubre el fallo del propio Verbatim, robo, incendio ni sobretensión. Las opciones evaluadas para la copia externa:
| Opción | Coste | Ventaja | Inconveniente |
|---|---|---|---|
| Disco USB rotativo | 60-70 € una vez | Desconectado, inmune a ransomware | Depende de acordarse de rotarlo |
| PBS remoto en casa de un familiar | Un mini PC | Automático por Tailscale | Hardware y sitio donde ponerlo |
| Nube (tipo Backblaze B2) | Menos de 1 €/mes por 110 GB | Fuera del control físico propio | Subida inicial lenta; cuota |
| Solo el vault a la nube | Casi gratis | Cubre lo más crítico en diez minutos | No cubre las fotos |
El plan: empezar por el export cifrado del vault, que es lo mínimo viable e inmediato, y añadir el disco rotativo para las fotos. Lo escribo porque ponerlo por escrito hace más probable que lo compre.
Fotos: Immich
Reemplazo autoalojado de Google Photos o iCloud: subida automática desde el móvil, reconocimiento facial, búsqueda por contenido. Fue el primer despliegue posible después de tener disco y backups: sustituir un proveedor con redundancia geográfica por un almacén sin copias habría sido un retroceso.
Recibió 4 núcleos y 4 GB, muy por encima del resto: el reconocimiento facial y
la detección de objetos son cargas sostenidas. La carpeta se llama library
y no photos porque Immich gestiona también vídeos, que en casi cualquier
biblioteca ocupan más que todas las fotos juntas.
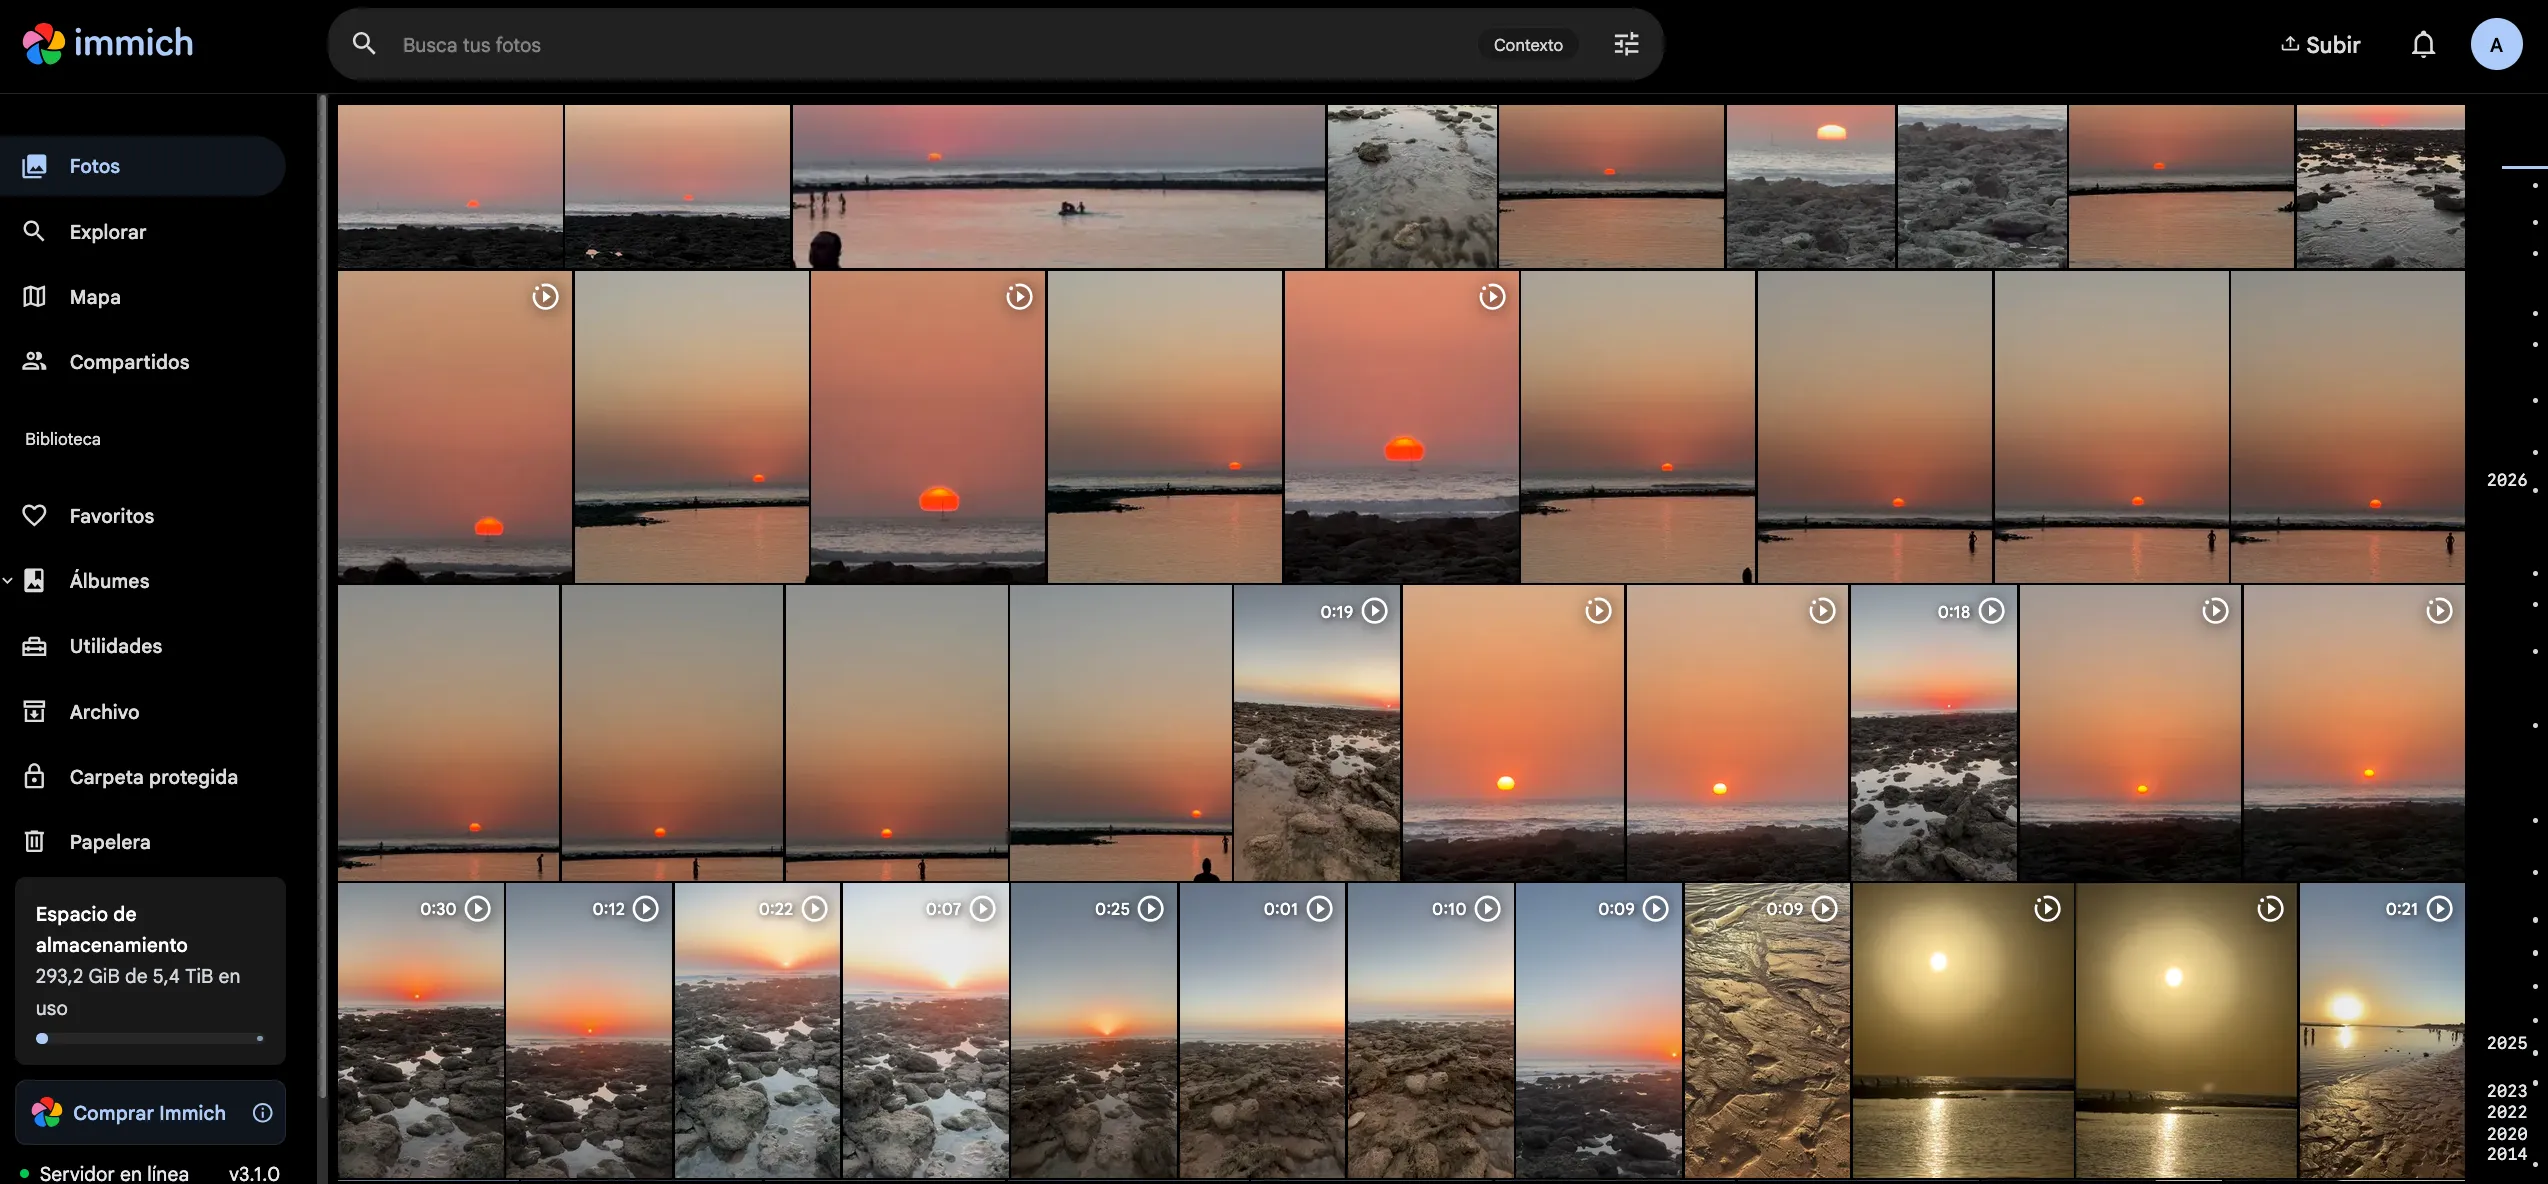
Un passthrough que se detuvo en la capa intermedia
Immich transcodifica los vídeos HEVC del iPhone a H.264 una sola vez, al
importarlos, y la tarjeta gráfica integrada lo acelera. El passthrough de
/dev/dri al contenedor se verificó y los dispositivos estaban. Aun así,
Immich fallaba con Device 'renderD128' does not exist.
La causa: Immich corre dentro de Docker, que corre dentro del LXC. Tres capas, y el passthrough solo cubría dos. Docker no hereda los dispositivos del sistema donde se ejecuta; hay que declararlos en el compose. Con Jellyfin el mismo passthrough bastaba porque Jellyfin corre nativo en el LXC, así que la verificación que allí era definitiva aquí solo comprobaba la mitad del camino.
Y un segundo nivel del mismo problema: una vez visible en Docker, el
dispositivo seguía sin poder abrirse (Device creation failed: -22). Ver el
dispositivo y tener permiso para usarlo son cosas distintas. En un contenedor
sin privilegios, ni siquiera root puede saltarse los permisos de un fichero
cuyo propietario cae fuera del rango mapeado de UIDs.
Errores cometidos
La sección más útil del documento. Los dieciocho están registrados con síntoma, causa y lección; estos son los que más enseñan.
Doble capa de VLAN
Configuré bridge-vlan-aware en el bridge de Proxmox y además VLAN 802.1Q
dentro de OPNsense sobre la misma interfaz. Dos sistemas etiquetando el
mismo tráfico. El síntoma era que los paquetes simplemente no llegaban
(Destination Host Unreachable en un sentido, tcpdump sin ver nada en el
otro), y el diagnóstico costó horas porque cada capa, por separado, estaba
bien. Elegir una estrategia y ser consistente: dos soluciones correctas
aplicadas a la vez al mismo problema dan una incorrecta.
Cambios que parecían permanentes
Tres veces el mismo patrón, y a la tercera dejó de ser casualidad:
| Caso | Qué parecía | Qué era |
|---|---|---|
ip_forward | Configurado con sysctl -p | La línea nunca llegó a /etc/sysctl.conf; un reinicio lo devolvió a cero en silencio y el acceso a la VLAN de laboratorio dejó de funcionar días después |
Regla udev del disco | Filtrando por «Verbatim» | ID_SERIAL reporta el Toshiba interno, no la carcasa |
lvm.conf | sed ejecutado sin error | Todas las coincidencias estaban comentadas: modificó una línea de ejemplo dentro de un comentario |
El hábito que los detecta todos: después de configurar algo, verificar leyendo el resultado, no asumiendo que el comando hizo lo que parecía. Y con un automatismo, la prueba definitiva es forzar el estado contrario y comprobar que se revierte.
El mismo error dos veces seguidas
Al añadir TLS a Vaultwarden, el contenedor se lanzó con -p 443:443, pero el
log decía claramente que Rocket escuchaba en el puerto 80 interno, TLS y
todo. El mapeo conectaba el exterior a un puerto donde no había nada:
tls handshake eof. Corregido a -p 443:80. Y al configurar Tailscale Serve
apunté al puerto 80 del contenedor, que no tiene nada mapeado hacia fuera.
Mismo error, misma causa, la segunda vez por no aplicar la lección de la
primera. Con docker run -p EXTERNO:INTERNO, solo el externo es alcanzable
desde fuera; lo primero ante un error de conexión es docker ps, no el
puerto que parece obvio.
Un formulario enviado sin el campo crítico
Al pedir el certificado wildcard, el formulario se envió con el token de
Cloudflare vacío. La interfaz devolvió un «Internal Error» que no decía
nada; el log del contenedor tenía el mensaje real (Invalid access token).
El segundo intento inmediato devolvió 429 Too many authentication failures: Cloudflare bloquea temporalmente tras varios fallos, así que
insistir empeora la situación. Dos lecciones: el log del contenedor tiene el
error real, y ante un fallo de autenticación contra una API externa no se
reintenta en bucle.
Dar por respaldado lo que nunca entró en el backup
Contado arriba. Un backup que termina bien no significa que contenga lo que
crees; la duración y el tamaño son señales diagnósticas; du -sh sobre el
datastore es la verificación más directa; y se verifica antes de destruir el
original. Aquí se comprobó antes de borrar las fotos del iPhone. De haberlas
borrado primero, la única copia habría sido el disco USB, sin respaldo y sin
saberlo.
Los cortos
- La web de Proxmox sirvió la ISO ARM64 al descargarla desde un Mac con Apple
Silicon. El USB no arrancaba y el fichero EFI se llamaba
bootaa64.efi. - Configuré OPNsense sobre el sistema live sin ejecutar el instalador. Tras el primer reinicio, todo desapareció.
- Las VLAN se configuraron como etiquetadas en el puerto del router en vez de en el del Dell. Una foto del switch antes de configurar ayuda.
ip addr addeip route addse perdían en cada reinicio. Lo permanente va en/etc/network/interfaces.bridge vlan add ... selfdejó el Dell sin red ni acceso web. Antes de tocar el bridge, tener monitor y teclado a mano.- Un
rm -rfejecutado en la shell del host en vez de en la del contenedor. No hizo daño porque la ruta no existía en el host, por pura coincidencia de nombres. Antes de unrm -rf, mirar el hostname del prompt. - Un servicio con protección anti-DNS-rebinding devuelve
401al accederlo por túnel SSH, porque la cabeceraHostno coincide. No es un fallo de ese servicio: es un patrón.
Cambio de operador
El 7 de septiembre se cambió de proveedor de internet y toda la infraestructura quedó inaccesible. La señal que orientó el diagnóstico fue que Tailscale tampoco funcionara: si solo hubiera fallado la IP local, podría ser enrutamiento, VLAN o switch; que fallara también el acceso remoto acotaba a una sola causa, que el Dell no tenía salida a internet. Sin internet no hay acceso remoto, así que hacía falta acceso físico.
La causa resultó trivial: el router nuevo venía en 192.168.0.x y el Dell
tenía IP estática en 192.168.1.x. Dos redes sin punto de contacto. Había dos
opciones: cambiar la LAN del router (un valor, en un sitio) o adaptar el
homelab al rango nuevo (IP del Dell, WAN de OPNsense, ruta anunciada en
Tailscale, reserva DHCP). Se eligió la primera por tres razones: menos
superficie de error, porque tocar la WAN de OPNsense sin túnel exige hacerlo
desde la consola y un fallo ahí deja sin red interna; el homelab no gana nada
con el cambio, porque el rango no responde a ninguna decisión de diseño; y se
repetirá, porque el próximo cambio de operador será el mismo ajuste.
La IP estática es cómoda hasta que cambia el entorno: es lo que mantiene el Dell localizable y lo que lo dejó incomunicado. Un homelab administrado en remoto necesita un plan para cuando lo remoto no funciona.
Lo que queda
Prioritario: la copia externa, que sigue siendo el hueco más grave. Después, monitorización (Uptime Kuma para saber si un servicio responde, Beszel para saber cómo está de salud). A medio plazo: un SAI con apagado ordenado, un rack pequeño de pared que saque el equipo del escritorio, un mini PC con cuatro puertos para sacar OPNsense de la VM, un punto de acceso con VLAN para segmentar el wifi, un laboratorio de Active Directory en la VLAN 50 y algo del lado defensivo (Wazuh o Security Onion).
Y una vigilancia periódica que ya está escrita: uso del thin pool y espacio del disco al mes, expiración de certificados al trimestre y, la que más se olvida y la única que demuestra que el sistema de backups sigue funcionando, una restauración de prueba cada tres meses.
Descartados con motivo: AdGuard Home (duplica a Pi-hole y parte la resolución DNS en dos sitios), Portainer (con dos contenedores Docker aleja de entender los comandos), Nextcloud (Immich cubre mejor el caso principal).
Notas de este proyecto
- Tres capas, dos problemas: un passthrough de GPU que se quedó a medias
El dispositivo estaba en el contenedor, la verificación lo confirmaba y aun así la app no lo veía. Porque la app corría una capa más adentro. Y cuando lo vio, no tenía permiso para abrirlo.
- Tres veces «parecía configurado»: verificar leyendo el resultado, no asumiendo
Un sysctl que no persistió, una regla de udev que nunca se habría disparado y un sed que editó un comentario. Ningún comando dio error. El hábito que detecta los tres es el mismo.
- Un backup que no se restaura es una carpeta grande con nombre tranquilizador
Monté copias automáticas de nueve máquinas y todo salía en verde. La biblioteca de fotos, el único dato irremplazable, estaba fuera. Lo delató un backup que terminó demasiado rápido.